Why
왜 만들기 시작했나
GPU 서버가 몇 대 있는데 각각 따로 놀고 있었습니다.
모델 하나 띄우려면 서버에 들어가 yaml을 만지고, 어느 서버가 비어 있는지는 직접 nvidia-smi를 쳐봐야 알고, 안 쓰는 모델이 GPU를 며칠씩 잡고 있어도 아무도 모릅니다. 기본 Kubernetes는 GPU가 NVLink로 묶였는지 PCIe로 묶였는지 모르니 배치도 그냥 빈 곳에 됩니다.
vanilla Kubernetes에 vLLM을 직접 올리는 것과 비교해 본 기록은 이 글에 있습니다. 그 글에서 겪은 번거로움이 이 프로젝트의 출발점입니다.
How
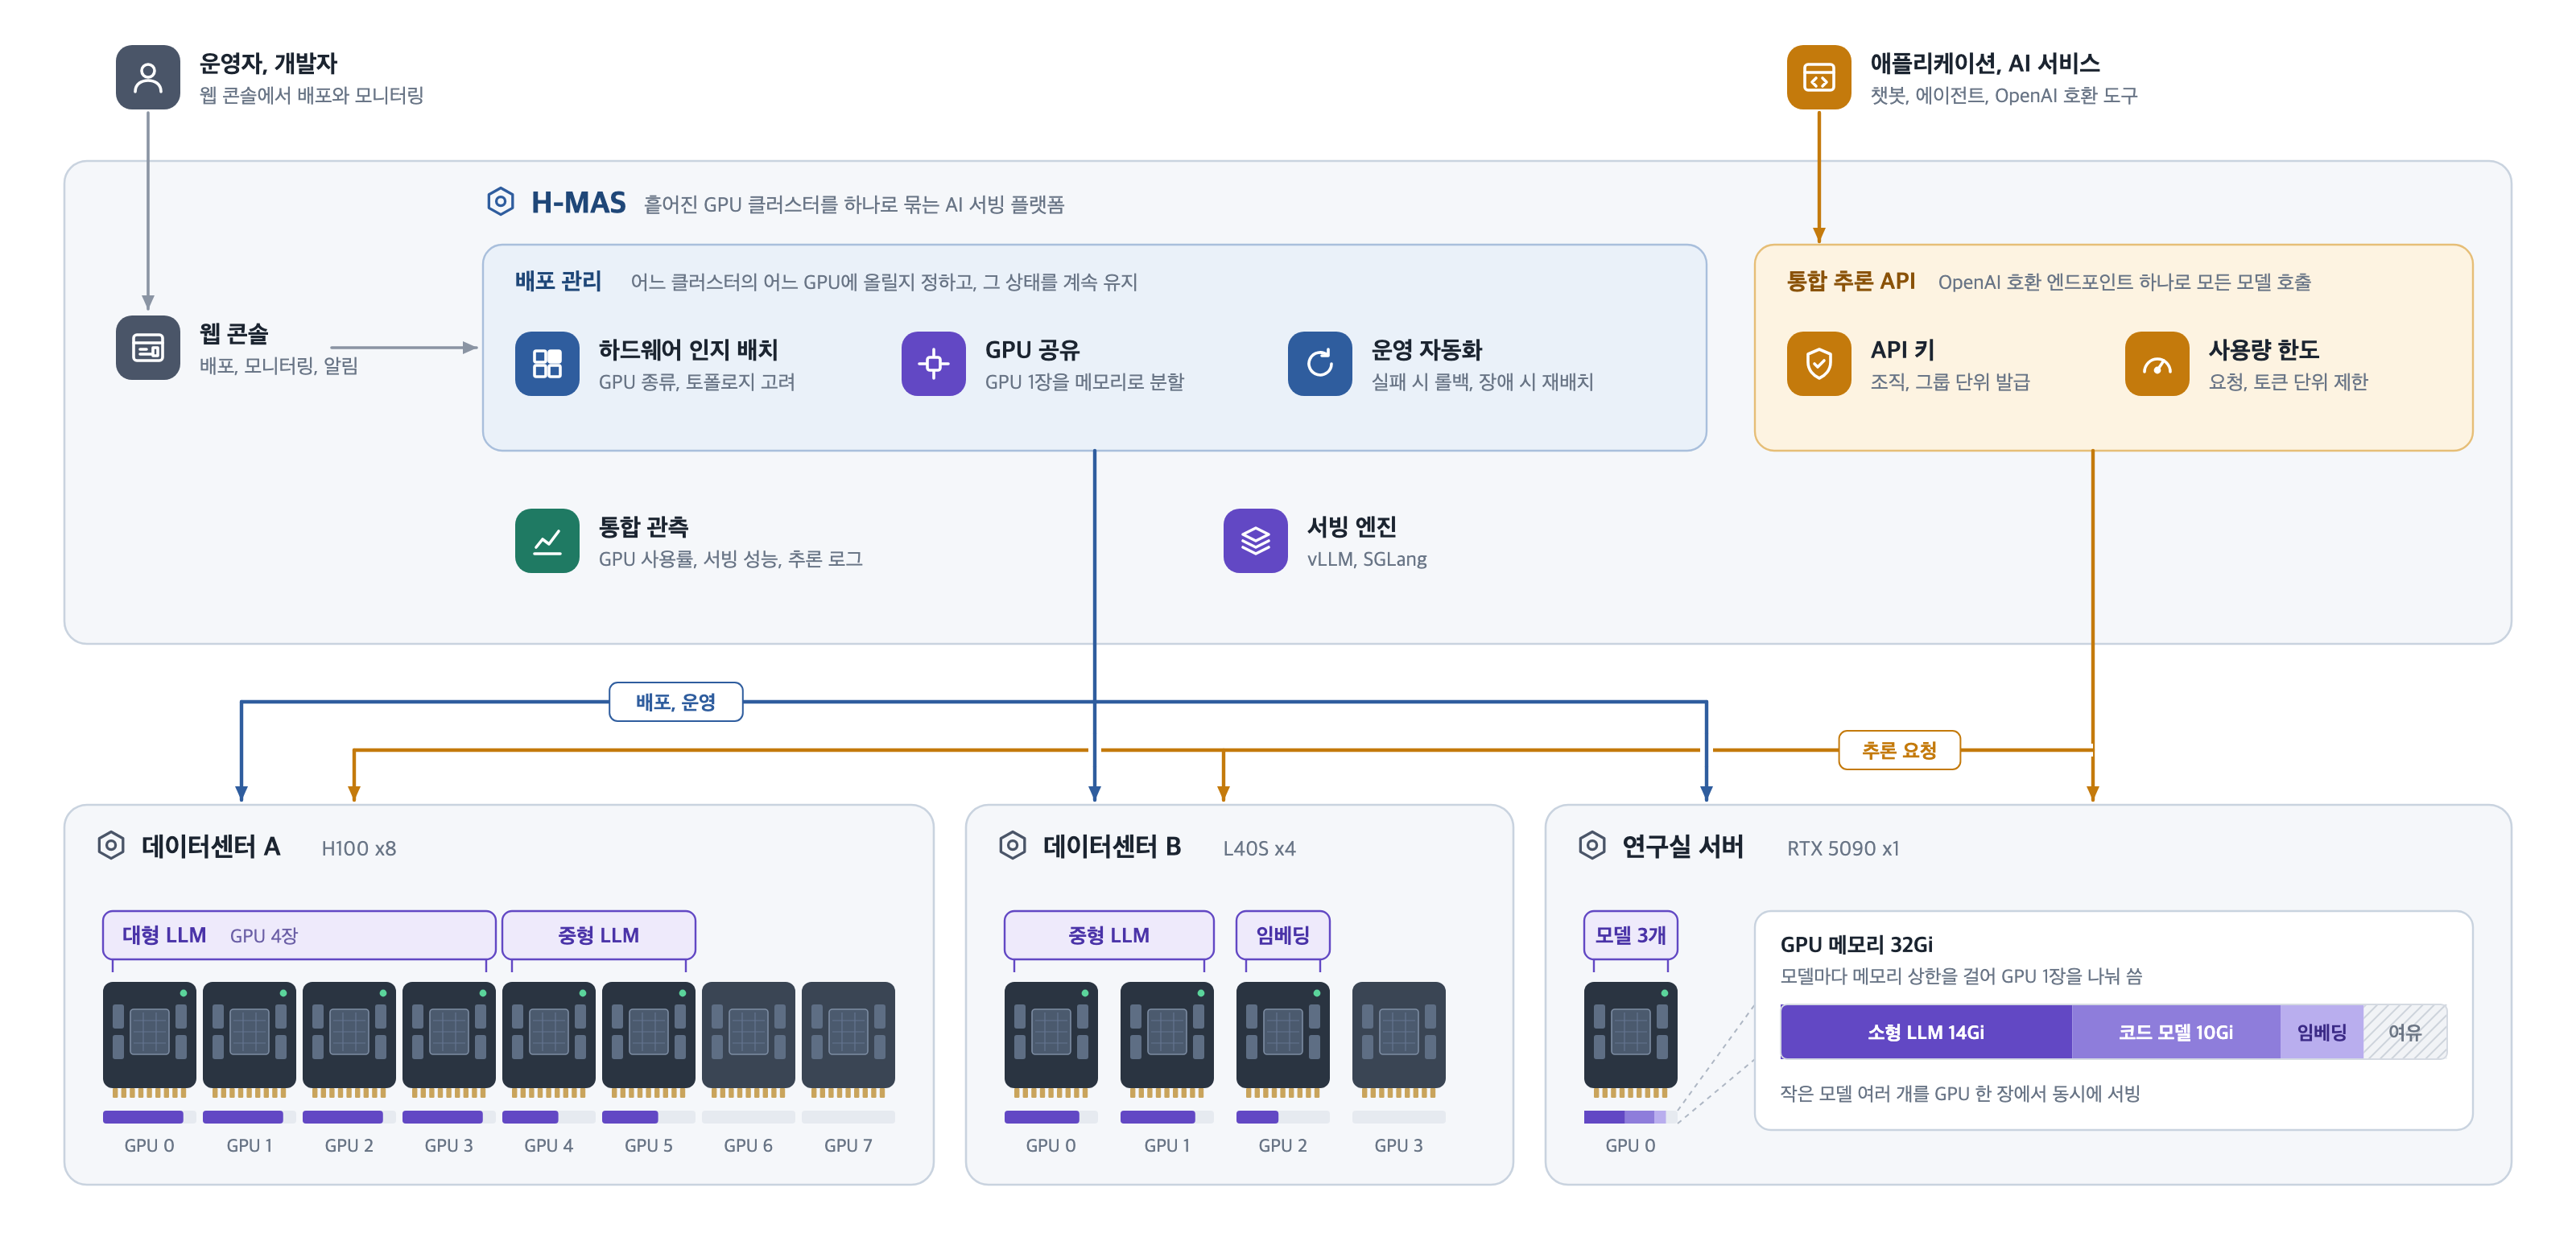
GPU를 묶고, 자동 배치하는 구조
흩어진 GPU 서버를 하나의 컨트롤 플레인으로 묶고, 모델을 알맞은 하드웨어에 배치합니다. 처음에는 클러스터를 고성능(HP)/가성비(GP)로 미리 나눠 뒀는데, 지금은 그 분류를 걷어내고 각 클러스터에 실제로 어떤 GPU가 있는지를 기준으로 삼습니다.
Console
웹 콘솔에서 모델만 고르면 끝
사람은 선택만, 나머지는 H-MAS가 처리합니다.
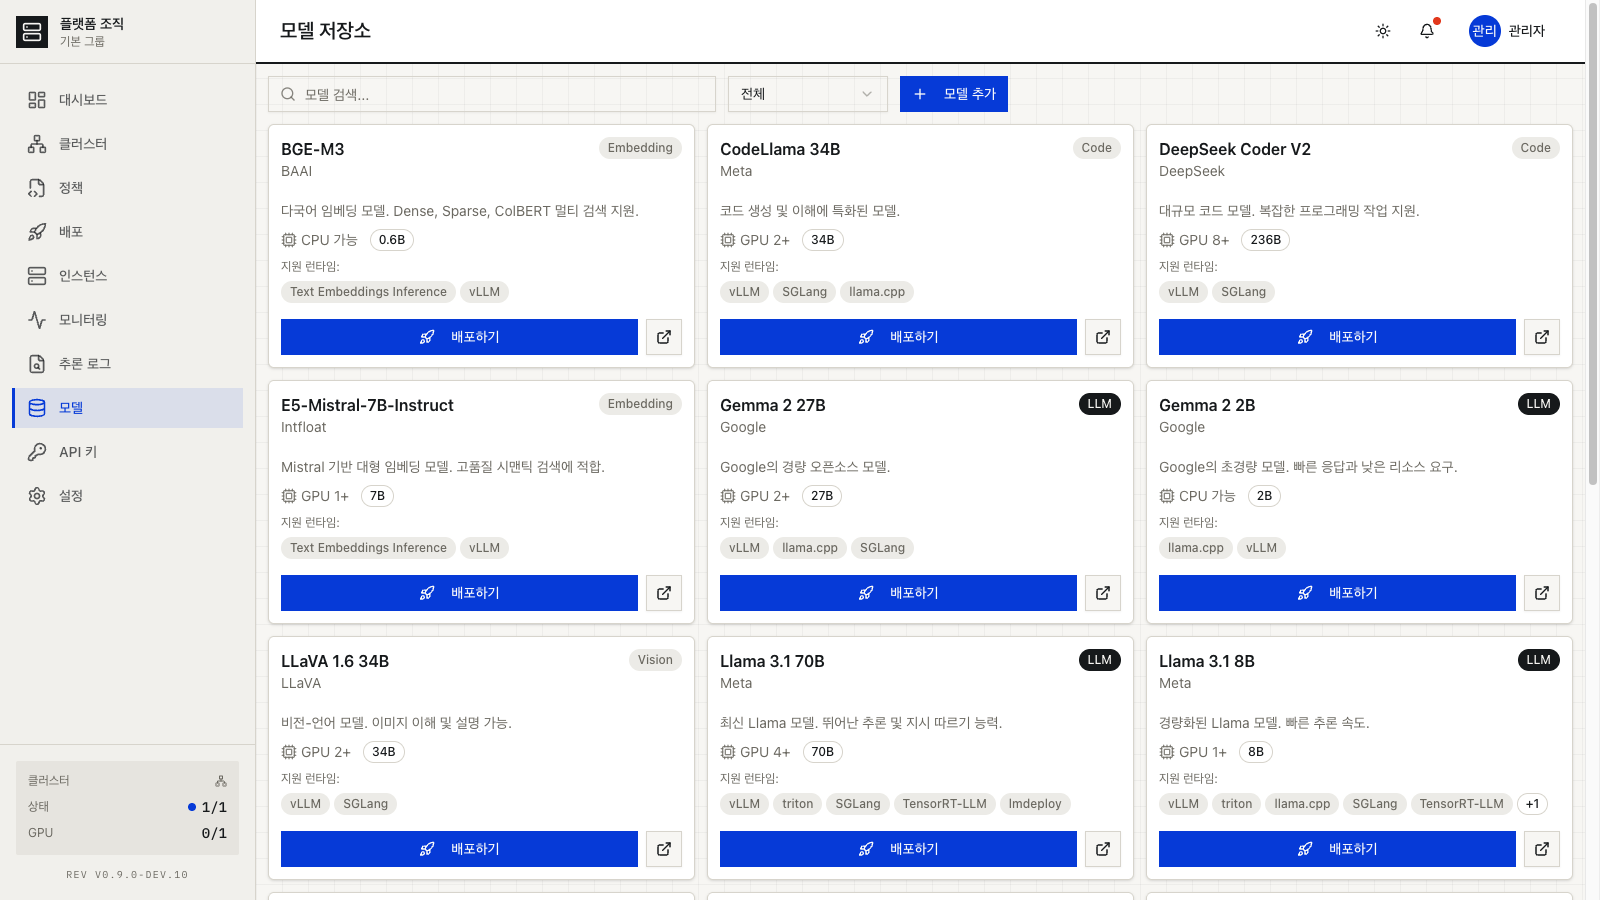
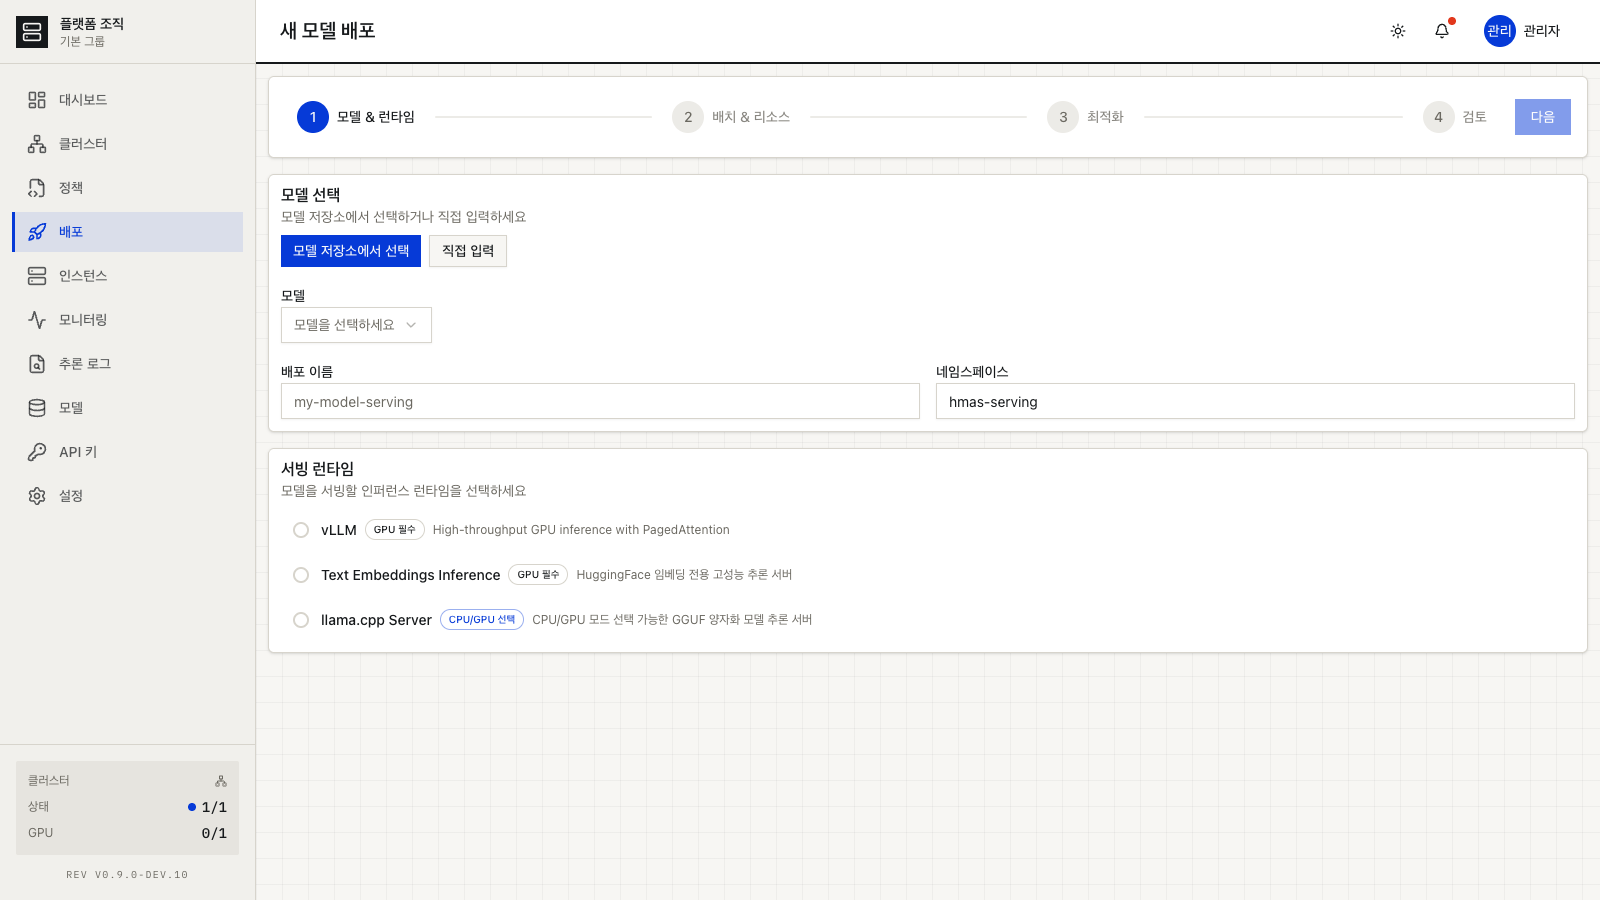
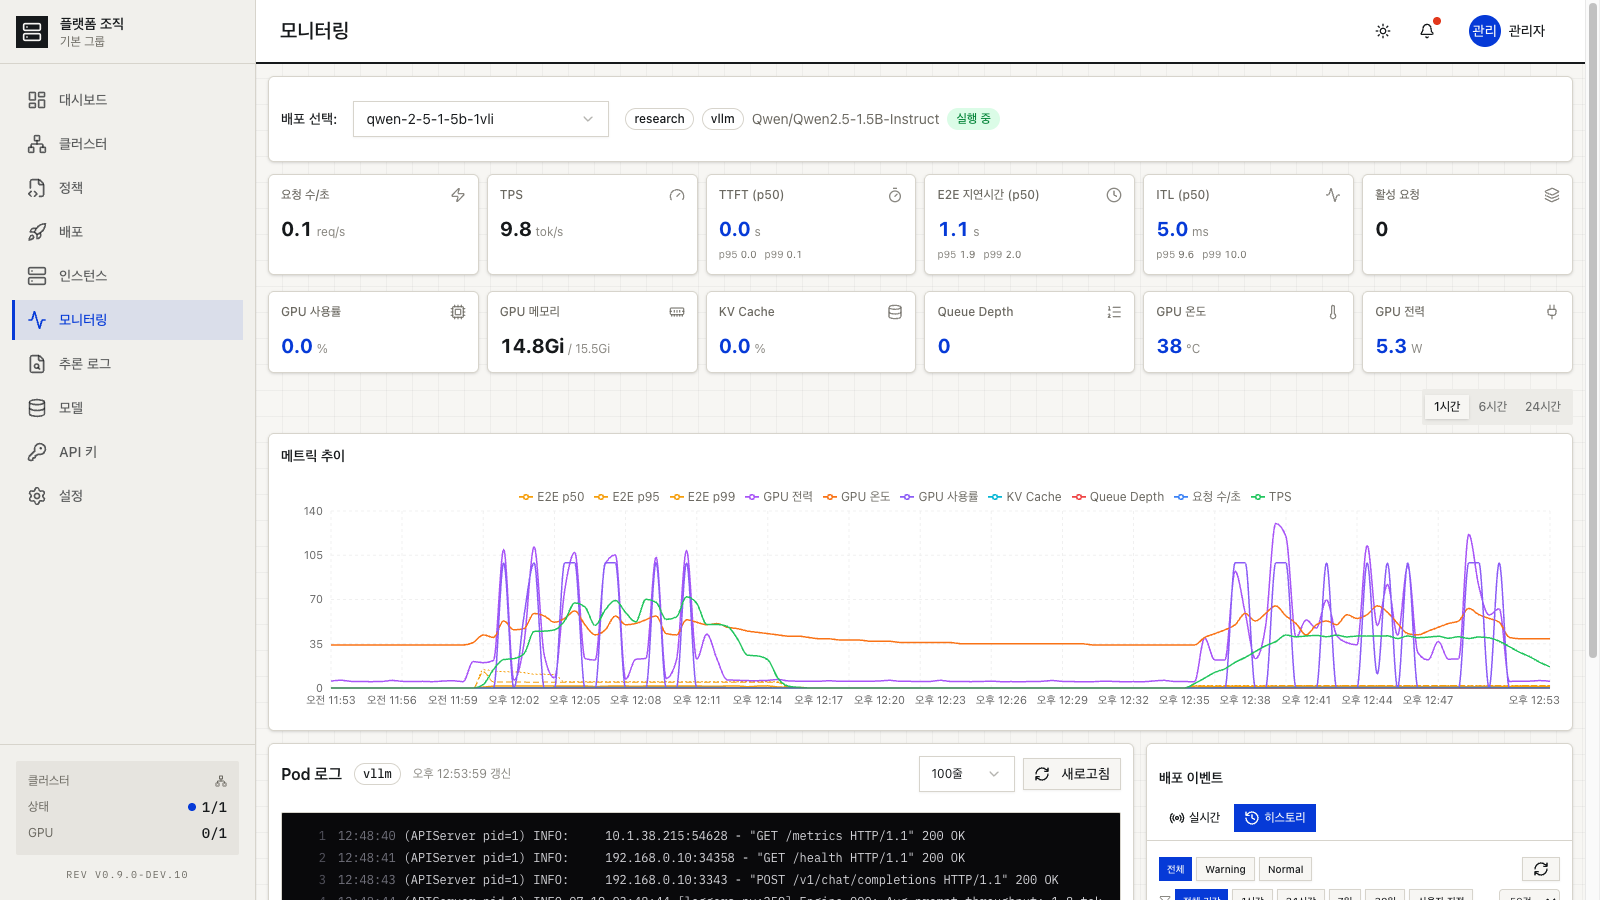
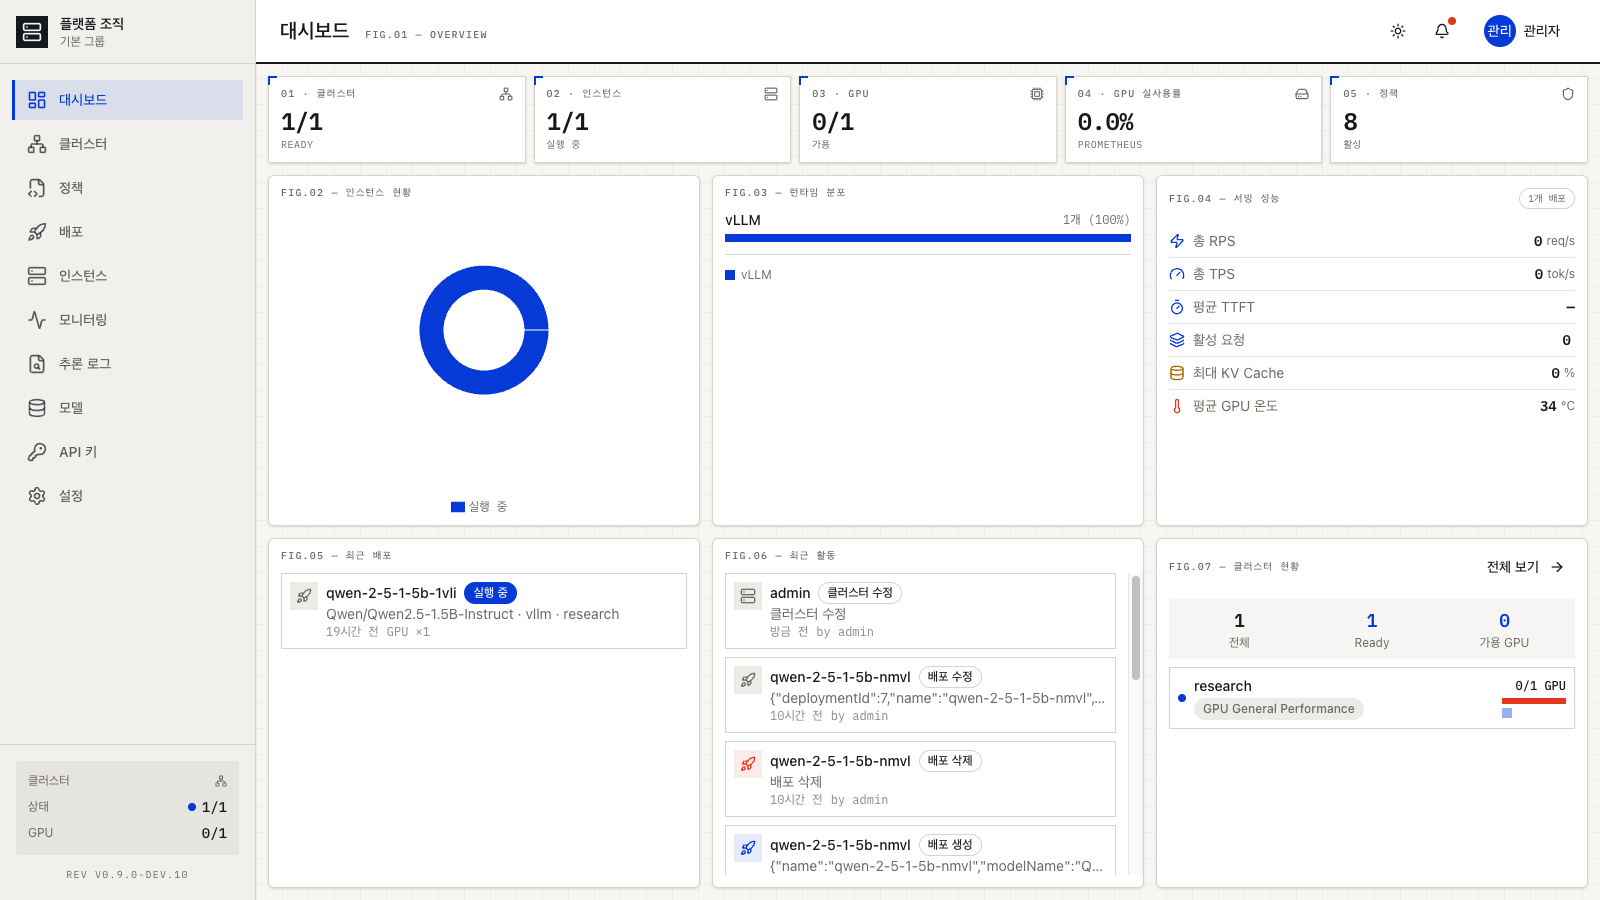
화면은 v0.9 기준입니다. 이후 런타임을 vLLM·SGLang 두 가지로 정리했고, 조직 전체 클러스터를 한눈에 보는 모니터링 대시보드가 추가됐습니다.
Status
지금 되는 것, 아직 안 되는 것
2026년 9월에 v0.9를 내고 지금은 v0.10을 만들고 있습니다. 주간 진행 상황은 개발 노트에 남깁니다.
되는 것
- 모델 등록 → 배포 → API 호출까지 멀티 클러스터에서 동작
- 모든 배포를 OpenAI 호환 주소 하나로 호출. 오픈소스 채팅 UI를 기본 설정 그대로 붙여 도구 호출(tool calling)까지 확인했습니다 (Qwen 계열)
- 서빙 런타임은 vLLM·SGLang. GPU 전용으로 방향을 정하면서 다른 런타임은 뺐고, 임베딩도 vLLM으로 서빙합니다
- GPU 1장을 메모리 단위로 나눠 여러 모델을 올리는 GPU 공유
- Prometheus 기반 TPS·지연시간·GPU·노드 사용률 메트릭, 조직 전체 모니터링 대시보드, Pod 로그
- 설정 변경 롤아웃과 실패 시 자동 롤백, 클러스터 간 Failover, 운영 알림
- 조직·권한 체계와 조직별 정책, 관리자 콘솔, API 키별 요청·토큰 한도
아직 안 되는 것
- 모델이 요구하는 자원과 GPU 토폴로지(NVLink/PCIe/NUMA)를 보고 클러스터를 자동으로 고르는 배치. 다음 버전(v0.11)에서 다시 설계합니다.
- 벤치마크 화면. 배포별 성능 기준값을 재는 기능은 서버 쪽에 들어갔고, 화면은 작업 중입니다.
- GPU 클러스터 추가를 명령 한 줄로 끝내는 것. 지금은 가이드를 따라 직접 구성합니다.
- 다른 환경에서의 검증. 지금까지는 제 클러스터에서만 돌려봤습니다.
- 소스 공개. 비공개로 진행하고, 과정은 개발 노트로 남깁니다.
Fit
이런 환경을 생각하고 만듭니다
GPU 서버가 몇 대에서 수십 대, 클라우드는 쓰기 어렵고, 서빙만 보는 사람은 따로 없는 곳. 기존 Kubernetes 위에 설치하고, 데이터와 모델은 그 안에 머뭅니다. 클러스터 하나에서 시작해 GPU 서버가 늘면 클러스터를 더 붙이면 됩니다.