Chunk를 작게 나누면 검색이 더 잘될까?
Series 1 — RAG는 원하는 문서를 제대로 찾고 있는가? (3/5)
지난 글은 원인표로 끝났습니다. bge-m3가 정답을 1위에 못 올린 33개 질문을 읽고 원인을 하나씩 붙였더니 여덟 가지로 모였고, 모델을 바꿔도 그대로 남는 세 줄(코드 혼동 8, 항목 경계 7, 긴 문서 3)에 실험 번호를 매겼습니다. 이번 글은 그중 가장 손대기 쉬운 줄, 긴 문서에서 시작합니다. 11만 자짜리 문서를 자르면 그 3건이 살아나는지, 그리고 자르면서 다른 무엇이 깨지는지.
청크 크기는 RAG를 만들 때 거의 처음 정하는 값입니다. 그리고 거의 항상 관습으로 정합니다. 512 토큰, 혹은 라이브러리 기본값 1,000자, overlap은 10~20%. 이번 실험의 목표를 한 문장으로 정하면 이렇습니다. Chunk 크기는 관습적으로 정하는 값이 아니라 실험으로 결정해야 한다. 이 문장을 증명하려면 “이 코퍼스에서는 512보다 256이 낫더라”로는 부족합니다. 그건 관습값을 다른 관습값으로 바꾸는 것뿐입니다. 보여야 하는 것은 크기를 하나로 고정하는 순간 어떤 질문이 손해를 보는지, 그리고 그 집합이 미리 알 수 없는 모양이라는 점입니다.
코드와 데이터는 rag-quality-lab의 experiments/03-chunk-size에 있습니다.
자르기 전에 코퍼스를 재 보니
실험 01의 코퍼스는 하이코리아 체류 매뉴얼을 자격 × 업무항목 단위로 나눈 672개 문서입니다. bge-m3 토크나이저로 세면 중앙값이 156 토큰입니다. 256 토큰을 넘는 문서가 226개, 512를 넘는 것이 122개, 1,024를 넘는 것이 63개입니다. 그러니까 로드맵에 적어 뒀던 256 / 512 / 1024 중 1,024로 자르면 문서의 9%만 잘립니다. 나머지 91%는 청킹을 하나 안 하나 같습니다.
그래서 격자에 128을 더했습니다. 중앙값 문서를 둘로 쪼개는 크기입니다. 그리고 청킹 없음을 ∞로 놓아 실험 01의 숫자가 같은 파이프라인에서 재현되는지 확인했습니다(Recall@5 0.789, 정확히 같았습니다). 크기마다 overlap 0과 25%를 붙여 청크 코퍼스 8개에 ∞까지 아홉 설정, 모델은 지난번처럼 bge-m3가 주이고 KURE-v1이 교차 확인입니다.
자르는 방식은 줄 단위 채우기입니다. 이 코퍼스의 줄은 문단 하나이거나 표 한 행입니다. 줄을 순서대로 담다가 크기를 넘기면 새 청크를 시작하고, 한 줄이 크기를 넘으면 그 줄만 토큰으로 자릅니다. LangChain의 RecursiveCharacterTextSplitter가 실제로 하는 일과 같습니다. 표 행이 중간에서 잘리는 일은 없으니 이번 결과는 순수하게 크기의 효과입니다. 청크마다 제목(“기업투자(D-8) > 체류기간 연장허가”)을 앞에 붙여 임베딩했고, 채점은 청크 top-100을 원래 문서로 합쳐 상위 10개 문서로 했습니다. 정답 라벨이 문서 단위라서 청킹을 어떻게 바꿔도 질문셋은 그대로입니다.
가설은 지난 글의 원인표에서 세웠습니다. 첫째, 정답 문서가 긴 질문은 청크가 작을수록 좋아진다. 둘째, 자격마다 반복되는 문구 때문에 헷갈리는 질문(CODE_CONFUSION)은 청크가 작을수록 나빠진다. 서류 목록이 잘게 쪼개지면 D-8 청크와 D-1 청크가 더 비슷해질 테니까요. 셋째, 그래서 평균은 평평하고 질문별로는 갈린다.
자르기만 해도 오르고, 크기 사이는 울퉁불퉁하다
bge-m3, overlap 0입니다.
| size | Recall@1 | Recall@5 | MRR | 청크 수 | 인덱스 |
|---|---|---|---|---|---|
| 128 | 0.684 | 0.921 | 0.787 | 4,189 | 17.2 MB |
| 256 | 0.697 | 0.882 | 0.777 | 2,270 | 9.3 MB |
| 512 | 0.671 | 0.921 | 0.778 | 1,378 | 5.6 MB |
| 1024 | 0.658 | 0.829 | 0.744 | 974 | 4.0 MB |
| ∞ | 0.566 | 0.789 | 0.676 | 672 | 2.8 MB |
먼저 눈에 들어오는 것은 ∞와 나머지의 차이입니다. 어떤 크기로든 자르면 Recall@5가 오릅니다. 가장 적게 오른 1,024가 0.789에서 0.829로 0.04, 가장 많이 오른 128과 512가 0.921로 0.13입니다. 질문 수로는 top-5 안에 정답이 든 질문이 60개에서 63~70개로 는 것입니다. 이 코퍼스에서 청킹은 할지 말지의 문제가 아닙니다.
그다음이 이 글의 출발점입니다. 크기 사이가 단조가 아닙니다. 128과 512가 0.921로 같고 256이 0.882로 꺼졌다가 1,024에서 0.829로 떨어집니다. KURE-v1은 128이 0.895, 256과 512가 0.908, 1,024가 0.855로 모양은 비슷한데 꺼지는 자리가 다릅니다. 질문이 76개라 하나가 0.013이니 256의 골짜기는 질문 3개 차이입니다. 이 표에서 “512가 최선”을 읽으면 안 됩니다. 읽을 수 있는 것은 “128에서 512까지는 평평하고 1,024부터 떨어진다”까지이고, 왜 평평한 구간 안에서 울퉁불퉁한지는 평균으로는 안 보입니다.
정답 문서 길이로 나누면
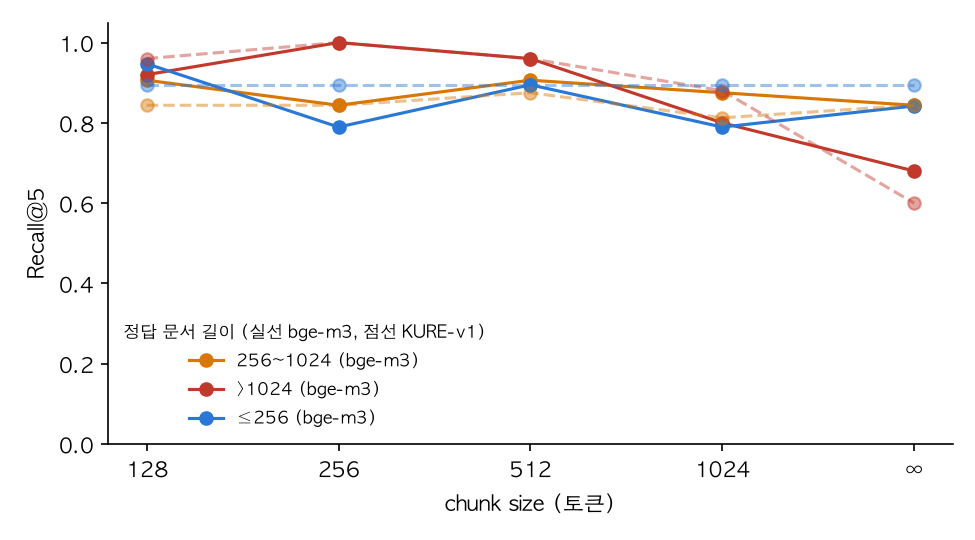
| 정답 문서 길이 | n | 128 | 256 | 512 | 1024 | ∞ |
|---|---|---|---|---|---|---|
| 256 토큰 이하 | 19 | 0.95 | 0.79 | 0.89 | 0.79 | 0.84 |
| 256~1,024 | 32 | 0.91 | 0.84 | 0.91 | 0.88 | 0.84 |
| 1,024 초과 | 25 | 0.92 | 1.00 | 0.96 | 0.80 | 0.68 |
긴 정답 25개는 예상대로입니다. ∞에서 0.68이던 것이 256에서 1.00까지 오릅니다. 지난 글의 LONG_GOLD_DOC 3건은 어느 크기에서든 살아났고, 11.6만 자짜리 “E-7 여권 갱신 시 등록사항 변경신고 기한”은 256 이상에서 1위입니다. 첫째 가설은 성립합니다.
예상 밖은 첫 줄입니다. 정답이 256 토큰 이하인 19개 질문은 정답 문서가 128을 빼고는 어디서도 안 잘립니다. 그런데 Recall@5가 128에서 0.95, 256에서 0.79로 흔들립니다. 정답이 안 잘리는데 왜 결과가 바뀔까요. 이 질문에 답하려면 평균이 아니라 질문 하나하나로 내려가야 합니다.
원인표를 다시 열어 보니 한 줄이 갈라졌다
지난 글의 33개 실패를 크기별로 다시 봤습니다. 값은 첫 정답 순위의 중앙값과 1위가 된 건수입니다.
| 원인 | n | 128 | 256 | 512 | 1024 | ∞ |
|---|---|---|---|---|---|---|
| LONG_GOLD_DOC | 3 | 1 / 2 | 1 / 3 | 1 / 2 | 1 / 2 | 없음 / 0 |
| CODE_CONFUSION | 8 | 2 / 3 | 1 / 5 | 1 / 5 | 2 / 3 | 4 / 0 |
| ITEM_BOUNDARY | 7 | 2 / 3 | 2 / 2 | 2 / 1 | 3 / 0 | 5 / 0 |
| QUERY_TWO_CODES | 4 | 1 / 2 | 1 / 3 | 1 / 3 | 1 / 2 | 2 / 0 |
| QUERY_NO_CODE | 5 | 없음 / 1 | 없음 / 0 | 없음 / 0 | 10 / 0 | 없음 / 0 |
| EXACT_TERM_MISS | 2 | 2 / 0 | 2 / 0 | 2 / 0 | 2 / 0 | 2 / 0 |
| HEADING_LOST_CONTEXT | 2 | 3 / 0 | 2 / 0 | 2 / 0 | 2 / 0 | 2 / 0 |
둘째 가설이 틀렸습니다. 나빠질 줄 알았던 CODE_CONFUSION 8건이 ∞에서 1위 0건이던 것이 256과 512에서 5건입니다. 왜 그런지 “D-8 비자 체류기간 연장할 때 서류 뭐 내야 해?”를 열어 봤습니다. 정답인 D-8 연장허가 문서는 3,580 토큰이고, ∞에서 코사인 0.691로 244 토큰짜리 D-1 연장허가 문서(0.715)에 졌습니다. 512로 자르니 D-8의 청크가 0.758로 top-6을 전부 차지합니다. D-1이 이긴 이유는 코드를 못 갈라서가 아니라 D-8 문서가 길어서 서류 목록 부분의 뜻이 나머지 3,000 토큰에 희석됐기 때문이었습니다.
그러면 진짜 코드 혼동은 어디 있을까요. 8건 중 정답이 짧아서 희석이 없는 두 건, “E-3 연구원 재입국허가 면제 조건”(234 토큰)과 “다른 비자에서 H-2로 자격변경 가능한가요”(245 토큰)만 모든 크기에서 계속 실패합니다. 지난 글에서 코드 혼동이라고 부른 8건 중 6건은 긴 문서 문제였고, 코드 한 토큰을 못 가르는 문제는 2건입니다. 원인 라벨은 사람이 정답 본문과 1위 본문을 읽고 붙인 것인데, 읽어서는 희석과 혼동이 구분되지 않았습니다. 다음 실험이 라벨을 다시 자른 셈입니다.
반대로 청킹이 손도 못 대는 줄이 있습니다. 코드 없는 질문 중 “항공기 조종사 채용하려면 어떤 비자”, “기업부설연구소 외국인 연구원은 어떤 비자”, “임금체불로 중재 중인 외국인은 어떤 체류자격”은 어느 크기에서도 top-10 밖입니다. 청킹은 어디를 보는지를 바꾸지, 무엇을 찾는지를 바꾸지 않습니다. 이 세 질문은 실험 06(키워드 검색)의 몫으로 그대로 남습니다.
그리고 작게 자르면 깨지는 것도 있습니다. “체류허가 신청 시 국내 발급 서류 유효기간”은 512에서 2위인데 128과 256에서는 top-10 밖입니다. 정답 문서의 제목이 본문을 말해 주지 않는 문서라(지난 글의 HEADING_LOST_CONTEXT), 잘게 자르면 제목도 본문도 질문과 안 닿는 조각만 남습니다. 이 문서는 문서 구조를 살려 자르는 다음 실험의 첫 사례가 됩니다.
정답이 안 잘리는데 순위가 바뀌는 이유
아까 미뤄 둔 질문입니다. 두 가지 메커니즘이 있었습니다.
경쟁자 노출. “D-10 첨단기술인턴은 뭐 하는 비자인가”의 정답은 D-10 활동범위 문서(472 토큰)이고 ∞에서 1위였는데, 128에서 4위로 떨어집니다. 정답은 안 잘렸습니다. 대신 2,984 토큰짜리 D-10 외국인등록 문서 안에 “첨단기술인턴 체류지원 특례”라는 문단이 있고, 128로 자르니 그 문단이 청크 하나로 드러나 0.683으로 정답(0.623)을 앞섭니다. ∞에서는 그 문단이 외국인등록 서류 목록에 묻혀 있어서 정답이 이겼던 것입니다. 청크 크기는 정답 문서가 안 잘려도 그 질문의 결과를 바꿉니다. 경쟁자가 바뀌기 때문입니다. “우리 문서는 짧으니 청킹은 상관없다”는 판단은 코퍼스의 긴 꼬리를 못 본 것입니다.
동점 복권. “D-2 시간제 취업 허용시간 늘리려면 성적이랑 토픽 몇 급”은 256에서만 7위입니다. 부록에 “시간제 취업 허용시간 확대” 문단이 여섯 섹션에 글자 하나 안 틀리고 반복됩니다. 256으로 자르면 첫 청크가 254 토큰으로 여섯 문서에서 완전히 같아지고, 코사인이 0.725로 동점이 되며, 정답은 정렬 순서에 따라 2위로 밀립니다. 512에서는 문서 길이가 452와 451 토큰으로 달라 0.735 대 0.733으로 정답이 이깁니다. 이 질문 하나가 256의 Recall@5를 0.013 깎았습니다. 본문이 같은 문서가 있는 코퍼스에서는 크기별 차이 한두 개가 이런 복권일 수 있고, 다중 정답 라벨 없이는 이걸 성능 변화로 잘못 읽게 됩니다.
크기 하나로 고정하면 몇 개가 손해를 보나
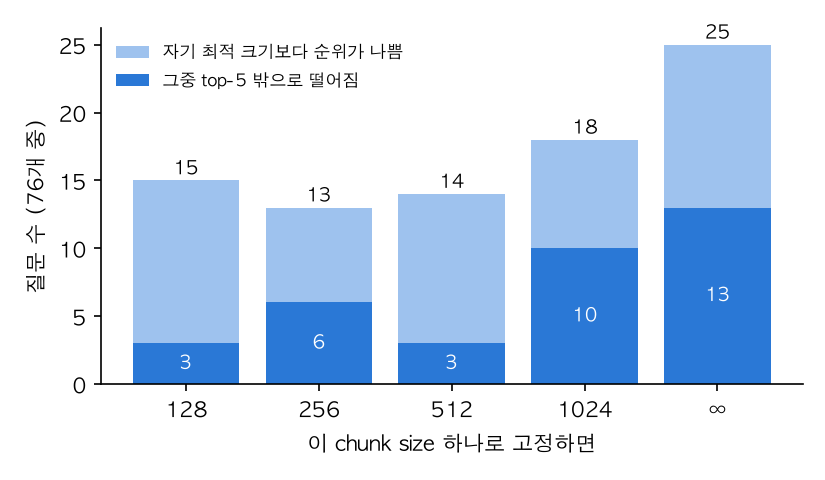
이제 목표 문장으로 돌아갑니다. 76개 질문 중 42개는 다섯 크기에서 순위가 같습니다(37개는 전부 1위). 나머지 34개는 크기에 따라 갈리는데, 그중 최적 크기가 하나뿐인 질문은 9개입니다. 대개 두세 크기가 동률로 좋고 나머지에서 떨어집니다. 그래서 “각 질문의 최적 크기”보다 반대로 물었습니다. 크기 하나로 고정하면, 자기 최적 크기보다 순위가 나쁜 질문이 몇 개인가.
| 이 크기로 고정하면 | 128 | 256 | 512 | 1024 | ∞ |
|---|---|---|---|---|---|
| 자기 최적 크기보다 순위가 나쁜 질문 | 15 | 13 | 14 | 18 | 25 |
| 그중 top-5 밖으로 떨어지는 질문 | 3 | 6 | 3 | 10 | 13 |
어느 값을 골라도 13개 이상은 다른 값에서 더 잘됩니다. KURE-v1은 14 / 18 / 20 / 23 / 28로 128이 가장 적습니다. 두 모델이 평균으로는 같은 “128~512 평평”인데 손해 보는 질문의 집합은 다릅니다. 이 집합이 어떤 질문으로 이뤄지는지는 위에서 본 대로 정답 길이, 경쟁 문서의 길이, 본문 중복 여부가 얽혀 정해지고, 셋 다 코퍼스와 질문셋을 돌려 보기 전에는 알 수 없습니다.
비용을 붙이면 선택이 좀 더 구체적이 됩니다. 임베딩 시간은 총 토큰이 같아서 크기와 무관하게 90~105초로 비슷합니다. 차이는 청크 수, 곧 인덱스 크기와 검색당 비교 횟수입니다. 128과 512는 Recall@5가 0.921로 같은데 인덱스는 17.2 MB 대 5.6 MB로 3배입니다. 이 코퍼스에서 128을 고를 이유는 없고, 512와 256 중 무엇을 고를지는 “어느 13~14개 질문을 포기할 것인가”의 문제입니다. 그 13개가 누구인지 아는 상태에서 고르는 것과 모르는 상태에서 고르는 것이 이 글이 말하려는 차이입니다.
overlap은 켜 두면 무난한 값이 아니었다
| model | size | R@5 overlap 0 | R@5 overlap 25% | 순위 오른 질문 | 내린 질문 |
|---|---|---|---|---|---|
| bge-m3 | 128 | 0.921 | 0.908 | 4 | 14 |
| bge-m3 | 512 | 0.921 | 0.882 | 7 | 7 |
| KURE-v1 | 128 | 0.895 | 0.921 | 8 | 10 |
| KURE-v1 | 512 | 0.908 | 0.895 | 6 | 8 |
방향이 없습니다. bge-m3 128에서는 오른 질문 4개, 내린 질문 14개로 손해고, KURE-v1 128에서는 이득입니다. 청크는 25% 늘고 임베딩 시간도 25% 늡니다. 나머지 크기도 마찬가지라 표에서 뺐습니다.
하다가 틀린 것들
overlap은 처음에 LangChain 방식으로 짰습니다. 새 청크를 시작할 때 직전 청크의 끝 줄들을 overlap 토큰 이내로 되감아 다시 담는 방식입니다. 돌려 보니 청크 수가 2~4%밖에 안 늘었습니다. 이유는 줄 길이였습니다. 이 코퍼스는 표 행이 길어서(6,324개 줄 중 128 토큰을 넘는 줄이 381개) 끝 줄이 overlap보다 긴 경계에서는 아무것도 안 겹칩니다. 인접 청크 쌍 중 실제로 겹친 비율이 128/32에서 13%, 512/128에서 10%였습니다. “overlap 유무”를 비교하려면 모든 경계에서 겹쳐야 하니 직전 청크의 마지막 N 토큰을 줄 경계와 무관하게 잘라 붙이는 방식으로 바꿨습니다. 실무에서 chunk_overlap=100을 켜 두고 안심하는 경우가 많은데, 줄이 긴 문서에서는 대부분의 경계에 적용되지 않을 수 있습니다. 설정값이 있다는 것과 설정이 작동한다는 것은 다릅니다.
둘째 가설이 틀린 것은 위에서 썼습니다. 틀린 가설이 원인표의 한 줄을 갈라 준 것이라 이번 실험에서 가장 쓸모 있는 결과가 됐습니다.
이 실험에서 남는 것
목표 문장으로 돌아가면, 이 코퍼스에서 청크 크기를 512로 관습적으로 정했다면 결과는 나쁘지 않았을 겁니다. Recall@5 0.921로 가장 좋은 축에 듭니다. 그런데 그 상태에서는 14개 질문이 다른 크기에서 더 잘된다는 것도, 그중 3개는 top-5 밖이라는 것도, 그 14개가 코드 없는 질문이 아니라 부록 문단이 중복된 질문과 제목이 본문을 말해 주지 않는 문서라는 것도 모릅니다. 관습값이 틀렸다는 게 아니라, 관습값은 무엇을 포기했는지를 말해 주지 않는다는 것입니다.
방법에서 남는 것은 두 가지입니다. 청크 크기의 효과는 평균이 아니라 질문별 순위표로 봐야 합니다. 평균은 128~512가 평평하다고 말하고, 순위표는 그 평평함 안에서 13~15개 질문이 자리를 바꾼다고 말합니다. 그리고 크기 효과는 정답 문서에만 걸리지 않습니다. 경쟁 문서가 잘리면서 새로 드러나는 문단, 본문이 같은 문서끼리의 동점이 순위를 정합니다.
원인표는 이제 이렇게 바뀝니다. 긴 문서 3건은 해결됐고, 코드 혼동은 8건이 아니라 2건이며, 코드 없는 질문 3건은 그대로이고, 작게 자르면 깨지는 문서(제목이 본문을 말해 주지 않는 문서)가 하나 드러났습니다.
재현은 이렇게 합니다. 첫 실행은 임베딩 16회라 30분쯤 걸리고 캐시가 있으면 2분입니다.
uv run experiments/03-chunk-size/chunking.py
uv run experiments/03-chunk-size/run.py
다음 글은 크기가 아니라 자르는 자리입니다. 이 매뉴얼에는 헤딩, 업무항목 라벨, 표 행이라는 구조가 있고, 그 경계에서 자르면 “국내 발급 서류 유효기간”처럼 작게 잘라서 깨진 문서가 살아나는지, 그리고 크기를 고정했을 때 손해 보는 13개가 줄어드는지 봅니다.