문서 구조를 이해해서 Chunking하면 더 잘 찾을까?
Series 1 — RAG는 원하는 문서를 제대로 찾고 있는가? (4/5)
지난 글은 “다음은 크기가 아니라 자르는 자리”라는 말로 끝났습니다. 청크 크기를 128에서 1,024까지 바꿔 봤더니 평균은 128~512에서 평평했고, 그 평평함 안에서 질문 13~15개가 자리를 바꿨습니다. 자르는 방식은 “줄을 순서대로 담다가 크기가 차면 끊는다”로 고정해 둔 채였습니다. 이번 글은 크기를 512로 고정하고 그 자리를 바꿉니다. 이 매뉴얼에는 1. ① - 같은 항목 표식이 있고, 그 표식 위에서 끊으면 “국내 발급 서류 유효기간”처럼 잘게 잘라서 깨졌던 문서가 살아나는지, 그리고 Recall@5가 보지 못하는 다른 무엇이 바뀌는지.
이번 실험의 목표를 한 문장으로 정하면 이렇습니다. 구조가 강한 문서에서는 ingestion 설계, 그러니까 문서를 어떻게 추출하고 어디서 자르느냐 자체가 retrieval 성능의 일부다. 이 문장은 결과가 나온 뒤에도 서 있습니다. 다만 “성능”이 어느 숫자에 나타나는지가 생각과 달랐습니다. 평균 Recall@5에는 전혀 안 나타났고, 조각 단위 지표의 평균에도 안 나타났고, 질문 하나하나의 득실 목록에서만 보였습니다.
코드와 데이터는 rag-quality-lab의 experiments/04-structure-chunking에 있습니다.
자르기 전에 코퍼스를 열어 보니, 구조가 이미 한 번 지워져 있었다
“구조를 이용해 자른다”를 짜기 전에 구조가 어디 있는지부터 봤습니다. 그랬더니 corpus.jsonl에는 없었습니다.
실험 01에서 코퍼스를 만들 때 HWP 원본을 XML로 뽑아 문단과 표 행을 줄로 만들었는데, 표 셀 안에 문단이 여러 개 있으면 공백 하나로 이어 붙였습니다. 이 매뉴얼은 본문 대부분이 큰 표 셀 안에 들어 있습니다. 그래서 원문의 ①②③, 1. 2. 3., - 같은 문단 경계가 코퍼스에서는 한 줄로 뭉개져 있었습니다. 줄 6,324개 중 900자(약 512 토큰)를 넘는 줄이 88개, 그 줄을 가진 문서가 71개, 그중 정답 문서가 76개 중 31개였습니다. D-8 체류기간 연장허가 문서는 원본 XML에서 문단이 81개인데 코퍼스에서는 첫 줄 하나가 5,000자였습니다.
지난 실험의 청커는 “한 줄이 크기를 넘으면 그 줄만 토큰으로 자른다”였습니다. 그러니까 정답 문서 31개는 항목 중간, 정확히는 괄호 안에서 토큰 단위로 잘린 채 지난 결과가 나온 겁니다. 512에서 D-8 연장허가의 첫 청크는 “④ 해외본사의 파견명령서(해외본사의 제3국 지사 발행” 에서 끝나고, 둘째 청크는 “파견명령서도 인정) ⑤ …” 로 시작합니다. 그런데도 그 질문은 1위였습니다. 조각이 문장 중간에서 끊겨도 조각 안에 “D-8”, “체류기간 연장”, “제출서류”가 가득하면 점수는 높고, 지표는 그 조각의 원래 문서가 정답인지만 보니까요. 어디서 잘렸는지는 순위 지표에 안 보입니다. 이 사실이 이번 실험의 두 가지를 정했습니다. 추출부터 다시 할 것, 그리고 지표를 하나 더 둘 것.
추출은 셀 안 문단 구분자를 공백에서 줄바꿈으로 바꾸는 한 줄 차이였습니다. 글자는 하나도 안 바뀌고(doc_id, 제목, 공백을 뺀 본문이 전부 같습니다) 줄만 6,324개에서 20,778개가 됐습니다. 900자 넘는 줄은 0개입니다. 원래 코퍼스는 실험 01~03의 기준선이라 손대지 않고 corpus_para.jsonl을 따로 뒀습니다.
조건 여섯 개와 지표 하나
크기는 전부 512입니다. 지난 실험에서 128~512가 평평했고 512가 비용이 가장 낮았습니다. 크기를 고정해야 “어디서 자르나”만 남습니다.
| 조건 | 추출 | 청킹 |
|---|---|---|
| A 토큰 | 원래 코퍼스 | 지난 실험의 512. 긴 줄은 토큰으로 자름 |
| B ∞ | 원래 코퍼스 | 자르지 않음(실험 01) |
| C 문단 | 문단 복원 | 문단을 순서대로 담아 512. 문단 안에서는 안 자름 |
| D 항목 | 문단 복원 | 1.·□ → ①·○ → - 표식 계층의 경계에서 끊음. 항목을 통째로 담아 512까지 채우고, 항목 하나가 넘으면 그 항목만 한 단계 아래 표식에서 같은 방식 |
| D’ 항목+경로 | 문단 복원 | D와 같고, 조각 앞에 상위 항목 제목을 경로로 붙임(“체류기간 연장허가 > 1. 법인에 투자(D-8-1) > 추가서류”) |
| E semantic | 문단 복원 | 인접 문단의 임베딩 유사도가 낮은 자리에서 끊음. 표식은 안 봄. 임계값은 청크 수가 D와 같아지도록 맞춤 |
A에서 C로 가면 자르는 자리가 문장 중간에서 문단 경계로 옮겨집니다. C에서 D로 가면 문단 경계 중 아무 데나(512가 차는 곳)에서 항목이 바뀌는 곳으로 옮겨집니다. D에서 D’는 조각에 “이 조각이 어느 항목의 일부인지”가 붙습니다. E는 표식 없이 유사도만으로 같은 자리를 찾아내는지 보는 대조군입니다.
지표는 지난번의 Recall@5·MRR에 하나를 더했습니다. answer coverage. 질문마다 정답 문서 안에서 답이 들어 있는 구간을 사람이 표시해 두고(76개, 중앙값 102 토큰), 검색 결과에서 정답 문서의 조각 중 순위가 가장 높은 것 하나가 그 구간을 글자 기준 몇 % 담고 있는지를 셉니다. 이게 coverage@1입니다. 상위 5개 조각 안의 정답 문서 조각들을 모아 세면 coverage@5입니다. 로드맵에는 Answer Groundedness라고 적혀 있었는데, 그대로 하려면 LLM이 답을 쓰고 다른 LLM이 채점해야 해서 시리즈 4와 35번으로 미루고, 그 전제 조건인 “답이 조각 안에 있나”만 떼어 쟀습니다. 자르지 않는 B는 찾기만 하면 조각이 문서 전체라 항상 1.0 아니면 0입니다.
가설은 방향까지 적었습니다. 첫째, Recall@5는 A·C·D 사이에서 거의 안 움직인다. 둘째, coverage@1은 A < C < D로 오른다. 셋째, D’는 답이 항목 하나 안에 숨어 있는 질문(지난 원인표의 ITEM_BOUNDARY 7건)의 순위를 올린다. 넷째, E는 D보다 coverage가 낮다. 유사도는 “① 신청서”와 “② 사업자등록증” 사이는 끊고 “⑫ … 2. 벤처 투자” 사이는 안 끊을 테니까요.
경계는 바뀌었는데 숫자는 안 움직였다
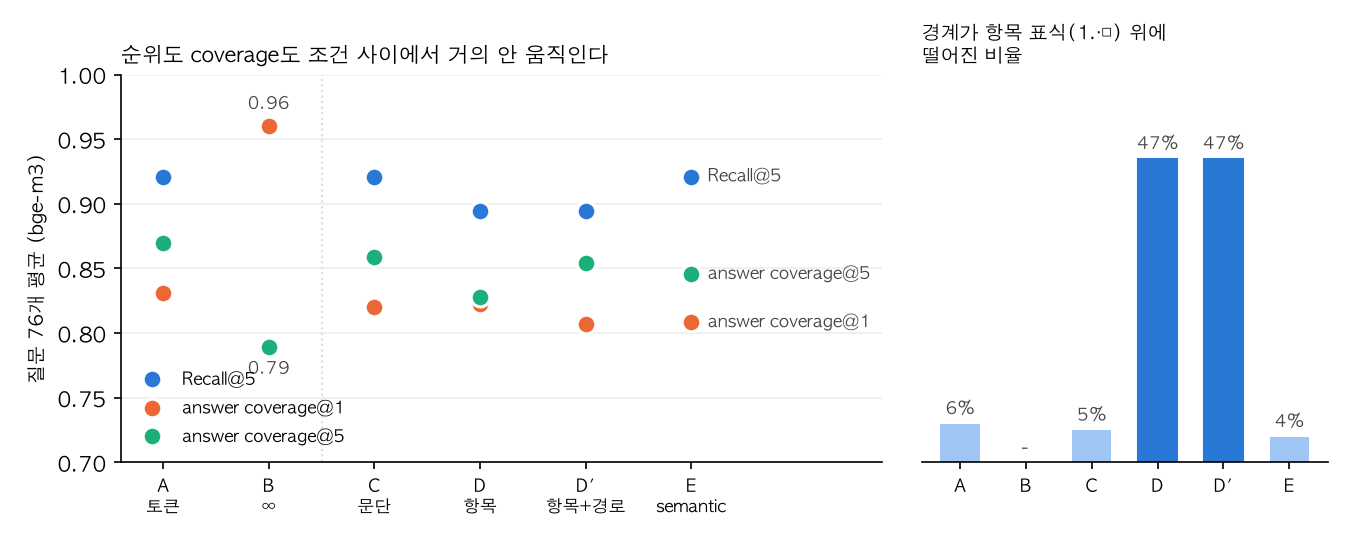
bge-m3입니다. 질문이 76개라 하나가 0.013입니다.
| 조건 | Recall@5 | MRR | cov@1 | cov@1 = 1.0 | cov@5 | 청크 수 | 경계가 항목 표식 위 |
|---|---|---|---|---|---|---|---|
| A 토큰 | 0.921 | 0.778 | 0.831 | 63 | 0.870 | 1,378 | 6% |
| B ∞ | 0.789 | 0.676 | 0.961 | 73 | 0.789 | 672 | - |
| C 문단 | 0.921 | 0.776 | 0.820 | 61 | 0.859 | 1,362 | 5% |
| D 항목 | 0.895 | 0.782 | 0.822 | 61 | 0.828 | 1,581 | 47% |
| D’ 항목+경로 | 0.895 | 0.784 | 0.807 | 60 | 0.854 | 1,581 | 47% |
| E semantic | 0.921 | 0.777 | 0.808 | 59 | 0.846 | 1,608 | 4% |
첫째 가설만 맞았습니다. Recall@5는 A·C·D·E가 0.895~0.921, 질문 2개 차이 안입니다. KURE-v1은 0.908 / 0.908 / 0.921 / 0.921 / 0.895로 D가 가장 높지만 역시 1개 차이입니다.
둘째 가설은 틀렸습니다. coverage@1은 A 0.831, C 0.820, D 0.822, D’ 0.807입니다. 오르지 않았고 굳이 말하면 조금 내려갔습니다. 조각 하나에 답이 통째로 든 질문 수도 63, 61, 61, 60입니다. KURE-v1은 0.857에서 0.769까지 더 뚜렷이 내려갑니다.
셋째 가설은 거의 안 움직였습니다. 8개 질문 중 D’에서 오른 것 1개, 내린 것 0. 넷째도 차이가 없습니다. E 0.808 대 D 0.822.
확실히 바뀐 것은 맨 오른쪽 열뿐입니다. 문서 첫 조각을 뺀 경계 중 1.·□ 같은 상위 표식 위에 떨어진 비율이 A 6%, C 5%에서 D 47%로 올랐고, 표식 없는 문단 한가운데 떨어진 비율은 83%에서 7%로 내려갔습니다. 구조 청킹은 켜졌고 작동했습니다. 그 결과가 평균 지표 어디에도 안 나타났을 뿐입니다.
표에서 하나 더 볼 것은 B입니다. B는 coverage@1이 0.961이고 Recall@5가 0.789입니다. 512로 자르는 조건들은 Recall@5를 0.13 얻고 coverage@1을 0.14 냅니다. 지난 글에서 “이 코퍼스에서 청킹은 할지 말지의 문제가 아니다”라고 썼는데, 그 이득은 “찾은 조각이 답의 일부만 담는” 비용과 교환된 것이었습니다. 지난 실험은 왼쪽만 봤습니다. 이번 조건 A~E는 그 교환 안에서 자리를 바꾸지 않습니다.
평균 밑에서는 다섯 개가 오르고 다섯 개가 내렸다
A에서 D로 가면서 coverage@1이 0.05 넘게 오른 질문이 5개, 내린 질문이 5개입니다. 조건에 따라 coverage가 갈리는 15개 질문을 하나씩 열어 보니 네 가지 일이 일어나고 있었습니다.
D가 살린 질문이 다섯입니다(q001 q005 q013 q023 q065). A와 C는 512가 차는 자리에서 잘라 답이 조각 둘에 걸쳤는데, D는 항목째로 담아 조각 하나에 답이 다 들어갔습니다. “외국인투자기업 상근이사가 대학에서 90일 이내 강의하려면”은 A에서 0.12였다가 D에서 1.00이 됩니다. 1위 조각이 “2. 외국인투자기업 CEO 등 우수전문인력의 대학 강연활동” 항목 전체(433 토큰)라서 활동범위, 대상, 제출서류가 한 조각에 있습니다. 11만 자짜리 E-7 외국인등록 문서의 “등록사항 변경신고 기한”은 C에서 0, D에서 1.00입니다. 지난 글의 q075, 제목이 본문을 말해 주지 않아서 작게 자르면 깨진다던 문서도 D에서 2위가 1위로 올라왔습니다. 경로 때문이 아니라 “1. 국내에서 발급·제출하는 서류의 유효기간은 … 3개월”이 항목 하나로 조각이 된 덕입니다.
D가 이웃 항목을 1위로 올린 질문이 하나 있습니다(q032). “E-1 교수 자격으로 변경할 때 학위·경력 기준”의 답은 문서 첫 항목 “1. 외국고급인력에 대한 교수(E-1) 변경”에 있습니다. A와 C는 문서 앞 512 토큰을 한 덩어리로 담아 그 안에 답이 있었는데, D가 항목을 갈라 놓으니 비슷한 이웃 항목 “3. 유학·구직에서 교수(E-1)로 변경”이 정답 항목보다 위로 왔습니다. 구조대로 자르면 비슷한 항목끼리 따로 경쟁하게 되고, 그 경쟁에서 정답 항목이 지는 경우가 생깁니다. D의 비용입니다.
답이 다른 말로 한 번 더 있어서 라벨이 못 센 질문이 셋입니다(q011 q069 q070). “선원취업 E-10 재고용하면 최대 몇 년”의 답 “4년 10개월”은 항목 1에도 있고 항목 2 “재고용 특례”에도 다른 문장으로 있습니다. D의 1위 조각은 항목 2이고 답이 실제로 들어 있는데, 라벨은 항목 1을 가리켜서 0으로 셉니다. “거주/숙소 제공 확인서”는 한 문서에 ②와 ⑥으로 두 번 나옵니다. 이건 D의 실패가 아니라 라벨의 한계입니다.
A의 우연이 있습니다(q011 q039 q069). A는 문서 앞에서 512 토큰을 뭉텅 잘라 답이 들어갔습니다. 구조 때문이 아니라 크게 잘라서입니다.
셋째 줄까지 감안하면 D는 A보다 나쁘지 않고 조금 낫습니다. 그러나 평균으로는 보여 줄 수 없습니다. 76개에서 5개 얻고 5개 잃으면 0.013 × 0입니다. 순위도 마찬가지입니다. A에서 C로 가며 순위가 오른 질문 5개·내린 질문 6개, C에서 D로 5개·8개, D에서 E로 8개·5개. 평균은 평평하고 그 밑에서 질문들이 자리를 바꿉니다. 이 실험의 결론은 “D가 낫다”도 “소용없다”도 아니고, 어느 질문에서 얻고 어느 질문에서 잃는지의 목록입니다.
구조에 맞추기와 조각을 크게 유지하기는 서로 당긴다
답 구간 길이로 나눠 보면 D가 왜 평균을 못 올렸는지 한 가지 이유가 더 보입니다.
| 답 구간(토큰) | n | A | C | D | D’ | E |
|---|---|---|---|---|---|---|
| ≤128 | 50 | 0.86 | 0.84 | 0.84 | 0.84 | 0.82 |
| 128~256 | 18 | 0.79 | 0.80 | 0.81 | 0.74 | 0.75 |
| 256~512 | 7 | 0.86 | 0.71 | 0.71 | 0.71 | 0.83 |
답이 짧은 50개는 조건과 무관하게 0.82~0.86입니다. 답이 256~512 토큰인 7개에서 A가 가장 높습니다. A의 조각이 가장 크기 때문입니다(중앙값 413 토큰, 512를 꽉 채웁니다). D의 조각은 중앙값이 309입니다. 항목을 통째로 담으면 512를 꽉 채우지 못하는 여유분이 생겨서 조각 수가 C보다 16% 많고 조각 하나는 작습니다. 긴 답은 그만큼 조각에 덜 담깁니다. “구조에 맞춰 자르면 조각이 온전해진다”는 말은 답이 항목 하나 안에 있을 때만 맞고, 답이 항목 둘에 걸치면 큰 조각이 이깁니다.
경로는 조각 하나를 깎고 조각 묶음을 올린다
D에서 D’로 가면 coverage@1은 0.822에서 0.807로 내려가는데 coverage@5는 0.828에서 0.854로 오릅니다. KURE-v1도 같은 방향입니다(0.784 → 0.769, 0.835 → 0.875). 질문별로 coverage@5가 내린 질문은 두 모델 다 0개입니다.
위의 q005에서 D의 1위는 항목 전체(433 토큰, coverage 1.00)였습니다. D’에서는 경로 “… > 2. 외국인투자기업 CEO 등 우수전문인력의 대학 강연활동”이 붙은 108 토큰짜리 하위 조각 “②전문인력(E-1, E-3~E-5, E-7) 자격소지자”가 1위로 올라와 coverage@1이 0.41로 떨어집니다. 경로가 하위 조각들을 모두 질문과 비슷하게 만들어서, 정답 항목의 조각들이 상위 5개 안에 모입니다. 조각 하나만 LLM에 준다면 경로는 손해고, 상위 몇 개를 묶어 준다면 이득입니다. 어느 쪽인지는 32번(작게 찾고 크게 보여주기)과 33번(몇 개를 넣나)에서 정해집니다.
semantic chunking은 임계값을 맞추니 C가 됐다
E는 인접 문단의 코사인이 임계값 아래면 끊습니다. 공정하게 비교하려고 청크 수가 D와 같아지도록 임계값을 맞췄더니 0.312까지 내려갔습니다. 인접 문단 코사인은 중앙값이 0.55라 그 아래로 떨어지는 쌍은 20,106쌍 중 325쌍, 1.6%뿐입니다. E의 경계 936개 중 대부분은 유사도가 아니라 512 상한에서 생겼고, E는 사실상 “C + 유사도 경계 325개”입니다. 그 325개가 표식 위에 떨어진 비율은 4%입니다. 유사도가 뚝 떨어지는 자리는 항목이 바뀌는 곳이 아니라 제목 줄의 앞뒤라서, E는 제목만 떼어 조각을 만듭니다. “E-6-1 예술인 근무처 변경 사후신고 되나”에서 E의 1위는 4 토큰짜리 “사후 신고대상”이고, “결혼이민 F-6 체류기간 상한”은 18 토큰짜리 “3년”입니다. 64 토큰 미만 조각이 C 188개, D 215개인데 E는 334개입니다.
넷째 가설의 전반부, “표식 없이 유사도만으로는 이 문서의 항목 구조를 못 찾는다”는 맞았습니다. 후반부 “그래서 D보다 나쁘다”는 틀렸습니다. 구조를 찾는 것과 지표가 오르는 것은 별개였습니다.
하다가 틀린 것들
coverage가 0인 자리를 열어 보니 측정을 세 번 고쳐야 했습니다. 첫째, 지난 실험의 청크는 토큰을 decode한 텍스트라 ④가 4로 바뀌고 HWP의 보이지 않는 문자가 사라져서 원문에서 그 조각의 위치를 못 찾는 경우가 있었습니다. 둘째, 한 문서 안에 같은 내용이 문단 버전과 표 버전으로 두 번 든 경우가 있었습니다. 라벨은 첫 등장만 가리켜서 복사본을 담은 조각이 0으로 집계됐고, 답 구간 문자열이 문서에 다시 나오면 그 자리도 답으로 치도록 바꿨습니다. 셋째, 표 버전은 코퍼스를 만들 때 넣은 셀 구분자 | 때문에 문단 버전과 글자가 달랐습니다. 세 번 고치고 나서도 “같은 사실을 다른 말로”는 못 셉니다. 위의 세 질문이 그렇습니다. 글자 단위 지표는 코퍼스의 중복부터 처리해야 하고, 그래도 남는 것은 라벨에 적어 둬야 합니다.
둘째 가설이 틀린 것은 위에 썼습니다. “구조에 맞춰 자르면 조각이 온전해진다”는 그럴듯한 문장이었고, 절반만 맞았습니다.
이 실험에서 남는 것
목표 문장으로 돌아가면, ingestion 설계는 retrieval의 일부가 맞습니다. 다만 그 효과를 보려면 두 가지를 바꿔야 했습니다. 지표를 바꿔야 했고(순위 지표는 어디서 잘렸는지를 안 봅니다), 해상도를 바꿔야 했습니다(조각 단위 지표도 평균으로는 득실이 상쇄돼 0입니다). 둘 다 바꾼 뒤에 보이는 것은 “구조 청킹이 낫다”가 아니라, 답이 항목 하나에 들어맞는 질문에서 얻고, 비슷한 항목이 이웃한 문서와 긴 답에서 잃는다는 목록입니다. 그 목록은 코퍼스와 질문셋을 돌려 보기 전에는 알 수 없습니다.
방법에서 남는 것은 셋입니다. 조작을 정하기 전에 그 조작이 닿을 자리가 데이터에 남아 있는지 확인할 것. 이 실험의 구조는 코퍼스에 없었고 원본에만 있었습니다. 전처리가 지운 것은 어떤 청커도 되살리지 못합니다. 그리고 “켜졌다”와 “작동했다”와 “효과가 있다”를 따로 셀 것. 경계가 표식 위에 떨어진 비율은 작동을 증명했고 지표는 효과를 부정했습니다. 둘을 같이 적어야 “효과 없음”이 “안 돌아갔음”과 구분됩니다. 마지막으로, 청킹의 이득은 찾은 조각이 답의 일부만 담는 비용과 교환된 것입니다. 지난 글은 그 교환의 왼쪽만 봤습니다.
원인표는 이렇게 바뀝니다. 항목 경계 7건은 항목 단위로 잘라도 거의 안 움직였습니다. 자르는 자리의 문제가 아니었습니다. 제목이 본문을 말해 주지 않는 문서 1건은 항목 단위로 잘라 살아났습니다. 코드 없는 질문 5건은 여전히 어떤 조건에서도 top-10 밖입니다.
재현은 이렇게 합니다. 임베딩 캐시가 있으면 3분, 없으면 8회 × 95초가 더 듭니다.
uv run experiments/04-structure-chunking/chunking.py
uv run experiments/04-structure-chunking/coverage.py
uv run experiments/04-structure-chunking/run.py
다음 글은 임베딩 모델입니다. 이 시리즈 내내 bge-m3가 주, KURE-v1이 교차 확인이었고 둘의 손해 보는 질문 집합이 달랐습니다. 모델만 바꾸면 검색 품질이 좋아지는지, 아니면 03·04에서 본 것처럼 평균은 같고 밑에서 자리만 바꾸는지 봅니다.
질문이나 의견, 함께 나누고 싶은 이야기가 있다면 편하게 연락 주세요. 연락하기 →